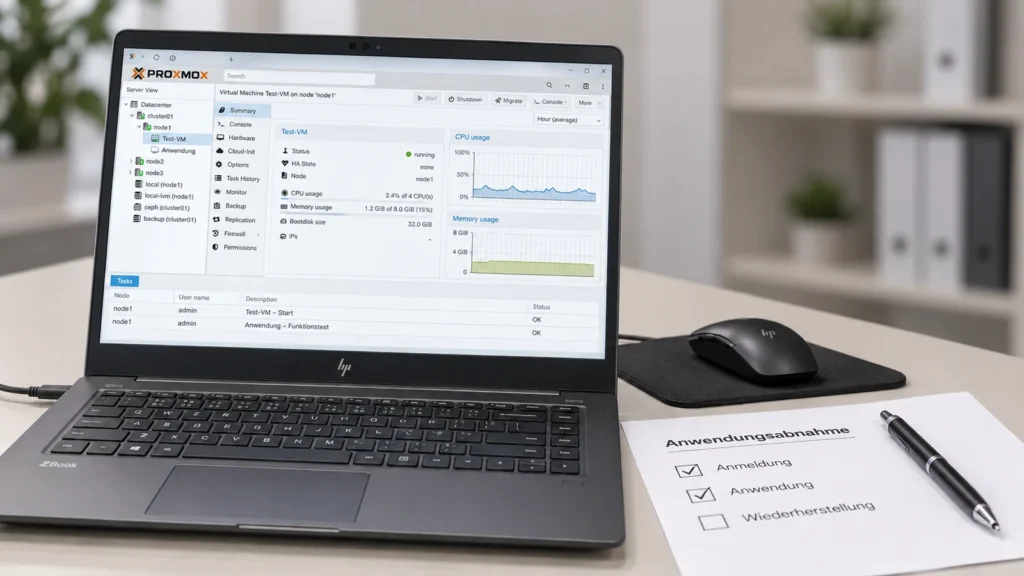
Un cluster peut prendre en charge la panne d’un hôte de virtualisation si ses prérequis sont remplis. Cela ne répare pas automatiquement un fichier supprimé par erreur ou une application endommagée. Haute disponibilité et sauvegarde répondent à des scénarios de défaillance différents.
Quelle panne la HA doit-elle prendre en charge ?
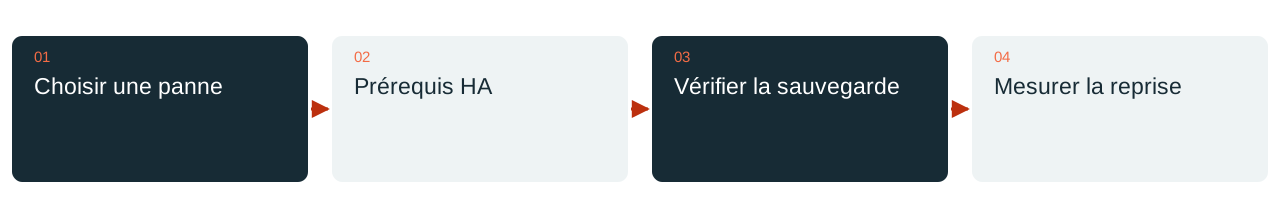
Proxmox HA surveille les services configurés et peut les redémarrer sur les nœuds disponibles après une défaillance appropriée. Le processus comprend la détection, l’isolement du nœud défaillant par fencing et un redémarrage. Il n’en découle aucune promesse générale d’application sans interruption.
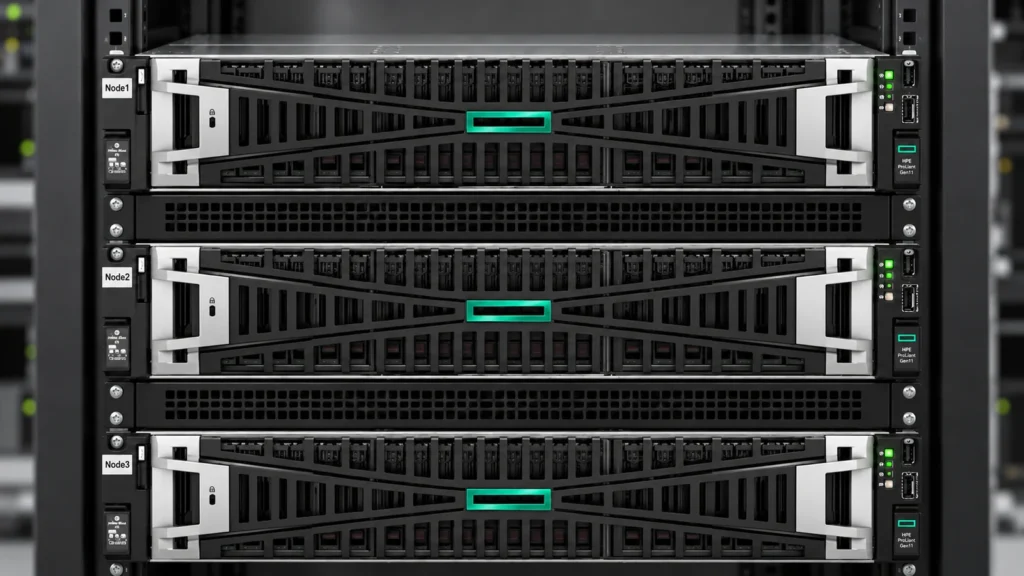
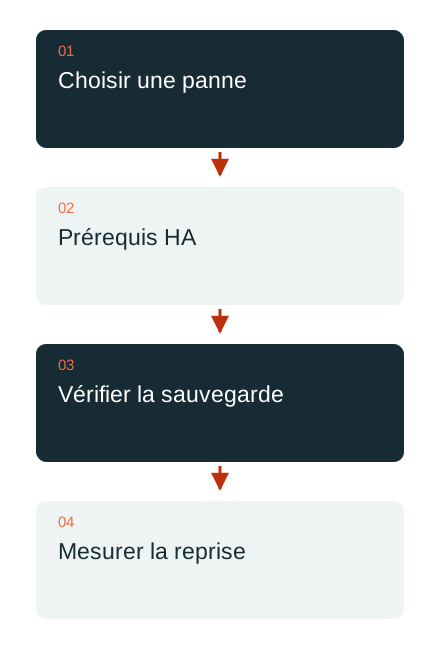
Le quorum, le fencing, le réseau et une stratégie de stockage adaptée constituent la base. La documentation du fabricant cite au moins trois nœuds de cluster pour un quorum fiable comme prérequis habituel de la HA. Les autres architectures sont évaluées séparément ; un petit équipement supplémentaire ne remplace pas automatiquement l’ensemble des ressources et des chemins de stockage nécessaires.
Les ressources restantes doivent suffire
Après la panne d’un hôte, les systèmes restants doivent pouvoir faire fonctionner les services prévus. Cela inclut la mémoire, la puissance de calcul, le réseau et les données réellement accessibles. L’utilisation normale de tous les nœuds au quotidien ne prouve pas que cette réserve existe.
Le choix du stockage est explicitement planifié. Le stockage partagé a ses propres dépendances, tandis que la réplication a son propre comportement d’actualisation des données. Un schéma de cluster comportant plusieurs cases ne prouve donc ni l’état des données disponible ni des performances suffisantes après une panne. Le scénario de défaillance pertinent est testé en pratique.
Les sauvegardes conservent un autre état
La HA peut aussi continuer à exploiter des données déjà erronées. Les contenus supprimés, les applications endommagées ou certaines conséquences d’une attaque nécessitent une sauvegarde indépendante adaptée. La conservation, les accès et l’environnement de restauration font partie de cette conception.
Le test de restauration vérifie un processus métier choisi. Une VM démarrée est une étape technique intermédiaire ; la personne responsable doit pouvoir utiliser l’application avec les données nécessaires. Le délai de reprise réalisable et la perte de données acceptée sont définis et mesurés comme des objectifs concrets.
Planifier la disponibilité comme un système cohérent
L’analyse ne s’arrête pas au logiciel de virtualisation. L’alimentation électrique, le réseau, le DNS, les identités et le stockage peuvent être des points de défaillance communs. Une fenêtre de maintenance nécessite un plan pour les ressources restantes et une procédure de retour adaptée.
DAXS planifie Proxmox selon les applications et les exigences opérationnelles. Un hôte unique correctement sauvegardé peut convenir à un besoin donné ; d’autres environnements nécessitent un ensemble HA bien dimensionné. La décision découle du risque de panne concret et de la reprise démontrée, pas seulement du nombre de serveurs disponibles.
Infrastructure et plateformes · Sauvegarde et restauration · Discuter des objectifs en cas de panne
Sources : Proxmox : prérequis HA documentés (lien externe) · Proxmox : fonctionnalités et options de restauration (lien externe)