Ceph, la réplication ZFS et un SAN ou NAS externe peuvent aider les VM Proxmox à traverser une panne d’hôte. Leur fraîcheur des données, leur reprise et leurs domaines de défaillance diffèrent. Cocher seulement « haute disponibilité » masque souvent l’exigence réelle : combien de minutes de perte de données l’application tolère-t-elle (RPO), et quand doit-elle redevenir utilisable (RTO) ?
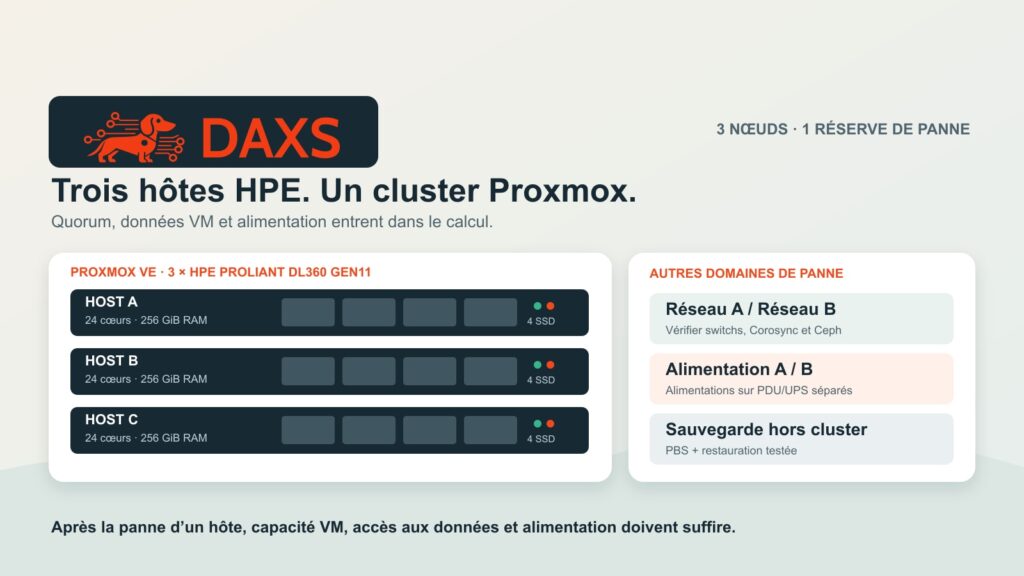
Nous comparons trois approches de stockage pour un même cluster hypothétique de trois hôtes. La reconstruction des copies Ceph après une panne d’hôte est décrite séparément. La décision commence ici par les applications et leurs objectifs de reprise vérifiables. Une sauvegarde distincte avec test de restauration reste nécessaire dans les trois cas.
Trois architectures, trois chemins de panne différents
Ceph sur SSD locaux fournit le disque VM sous forme de stockage bloc distribué, accessible dans tout le cluster. Un pool répliqué conserve les copies sur plusieurs hôtes ; quorum, règle du pool, réseau et capacité libre doivent correspondre au domaine de défaillance hôte choisi. Après la panne d’un hôte VM, Proxmox HA peut redémarrer la VM ailleurs si quorum et ressources sont disponibles. Une écriture en cours, l’application invitée et ses transactions restent à évaluer dans le test. La seule redondance Ceph ne promet ni VM sans interruption ni RPO nul garanti pour toute application.
ZFS local avec réplication du stockage Proxmox transfère périodiquement les volumes VM par snapshot vers un autre hôte. La cible possède l’état de la dernière réplication terminée avec succès . Proxmox autorise HA avec cette réplication, mais signale explicitement une perte possible depuis la dernière synchronisation. Un intervalle configuré à cinq minutes ne garantit donc pas globalement le RPO : retards, échecs de tâches et état applicatif comptent. Sans disque partagé synchrone, la VM redémarrée doit pouvoir fonctionner avec cet état antérieur précis.
Le stockage partagé externe comme NFS ou iSCSI rend les disques VM accessibles à plusieurs hôtes et permet généralement la migration à chaud sans copie du disque. En cas de panne d’hôte, le risque sur les données dépend du stockage réel. Vérifier deux contrôleurs, des chemins de données et d’alimentation distincts, le multipathing iSCSI ou des chemins réseau NFS redondants, le support et une bascule de contrôleur testée ; un NAS unique reste un domaine de panne central. La documentation Proxmox met explicitement en garde contre une appliance ZFS-over-iSCSI devenue point unique de défaillance. « Shared » dans la configuration ne prouve pas la redondance de l’appliance.
Quel workload tolère quels RPO et RTO ?
Le RPO mesure la perte maximale de données acceptée, le RTO le délai maximal avant une application utilisable. Les indications suivantes sont des questions de décision, pas des SLA de produit. Pour chaque service, tester ensemble base de données, redémarrage VM, DNS, connexion utilisateur et systèmes dépendants.
| Application et objectif | Approche plausible | Contrôle décisif |
|---|---|---|
| Base ERP transactionnelle ; perte de données très peu tolérée | Ceph ou stockage partagé dont la redondance est démontrée ; éventuellement réplication applicative en plus | Latence d’écriture, cohérence transactionnelle, quorum et redémarrage réel lors d’une panne hôte/stockage |
| VM de test interne ou service web restaurable ; perte de quelques minutes acceptée | ZFS local avec réplication peut suffire | Âge du dernier snapshot réussi, alerte de retard, démarrage sur un état antérieur |
| SAN/NAS existant, supporté et doté de réserves suffisantes | Continuer à l’utiliser comme stockage partagé peut être économique | Tester ensemble contrôleurs, chemins, énergie, firmware, contrat de maintenance et bascule réelle |
Pour une base de production au RPO très serré, la réplication ZFS asynchrone peut être inadaptée même si le redémarrage HA fonctionne. Inversement, un service de test restaurable ne justifie pas automatiquement Ceph. Trois hôtes Proxmox ne rendent pas un serveur de stockage unique redondant. Le choix suit la perte de données acceptée et l’interruption mesurée, au-delà du nom du produit.
Calcul sur trois et cinq ans sans faux prix de marché
Le comparatif hypothétique suppose trois hôtes identiques à un socket au prix d’achat h par hôte et un serveur de sauvegarde séparé avec supports au prix b . Selon le tarif actuel du fabricant, Proxmox VE Standard coûte 550 € par socket CPU occupé et par an ; Proxmox Backup Server Standard coûte 2 240 € par serveur et par an. Le support commun représente donc 3 × 550 + 2 240 = 3 890 € annuels. Le modèle retient 90 € nets par heure travaillée. Il ne suppose pas sans contrôle les mêmes IOPS ou capacité utile : les offres réelles doivent d’abord être normalisées pour le même workload.
d désigne les SSD de données Ceph supplémentaires par hôte, z l’équipement SSD ZFS local par hôte, a une appliance externe conçue redondante, nc, nz et ns les investissements réseau ou fabric nécessaires à chaque approche. ec, ez et es sont les coûts annuels supplémentaires d’énergie/colocation ; s désigne le contrat annuel de service fabricant de l’appliance externe. Toutes les lettres représentent des montants de devis nets en euros, pas des prix de marché affirmés.
| Approche | Installation / exploitation annuelle | 3 ans | 5 ans |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32 370 + 3ec € | 3h + b + 3d + nc + 49 150 + 5ec € |
| Réplication ZFS | 50 h / 30 h | 3h + b + 3z + nz + 24 270 + 3ez € | 3h + b + 3z + nz + 37 450 + 5ez € |
| Stockage externe | 60 h / 35 h | 3h + b + a + ns + 26 520 + 3s + 3es € | 3h + b + a + ns + 40 600 + 5s + 5es € |
Les heures sont de simples hypothèses de modèle, pas un forfait DAXS. Exemple : 1 000 € de service annuel supplémentaire sur l’appliance augmentent l’option externe de 3 000 € sur trois ans et 5 000 € sur cinq ans. Une appliance existante peut réduire a sur la période, mais durée de vie restante, support, pièces et extensions relèvent de s ou d’un poste d’investissement distinct. Prix matériels, occupation du stockage, profil de performance, réseau, fiscalité et lieu d’exploitation exigent des devis. Sans mêmes capacité utile, IOPS, RPO et RTO, la plus petite formule ne décide pas l’achat.
Réception : tester réellement une panne par domaine de défaillance
DAXS demanderait quatre preuves pour chaque architecture candidate : (1) relever l’heure du dernier état applicatif cohérent, (2) mesurer panne d’hôte et redémarrage VM sous charge, (3) interrompre aussi le chemin critique de stockage ou réseau et (4) restaurer une VM et des données applicatives individuelles à partir d’une sauvegarde distincte . Pour ZFS, inclure une réplication échouée ou retardée ; pour Ceph, le pool dégradé et sa reconstruction ; pour SAN/NAS, la bascule des contrôleurs et chemins. Les mesures déterminent si RPO et RTO sont atteints.
Les copies Ceph, snapshots de réplication et miroirs de baies propagent aussi suppressions et données erronées. Ils ne remplacent ni versions, ni copie externe, ni test de restauration. L’article DAXS Proxmox Backup Server : vérification, conservation et restauration approfondit la réception des sauvegardes. Avec une liste d’applications et des objectifs RPO/RTO, on peut, via Contact , faire mesurer avec DAXS les trois approches face à la charge réelle et aux contrats existants.
Sources : Proxmox VE Administration Guide : stockage, réplication du stockage et HA · Proxmox VE : tarifs actuels du support · Proxmox Backup Server : tarifs actuels du support.