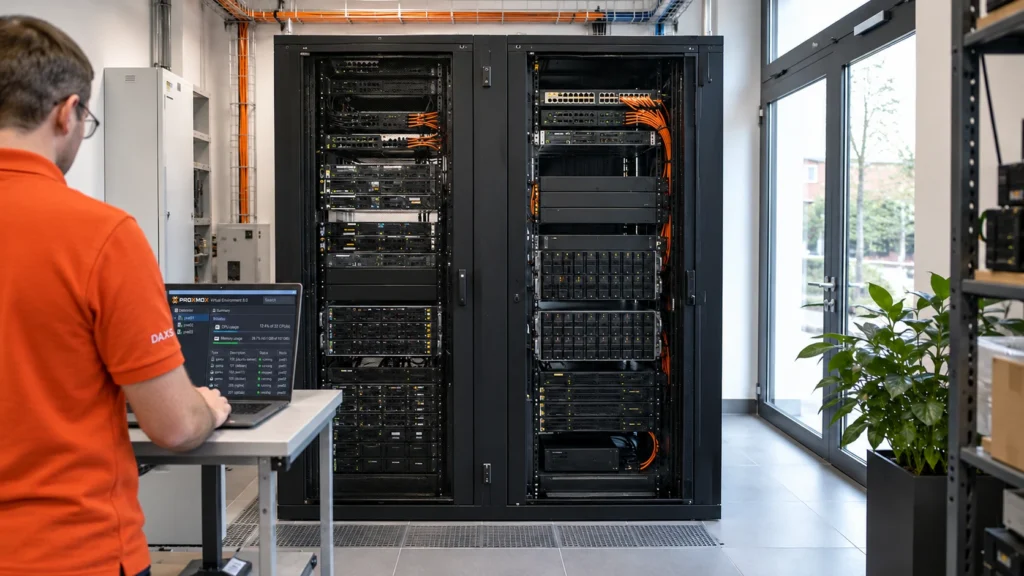
L’hôte Proxmox existant dispose encore de capacité pour un service IA. Suffit-il d’installer une carte graphique et de créer une machine virtuelle ? Cette solution peut être pertinente si l’affectation du GPU, les ressources de l’hôte et la maintenance sont planifiées ensemble.
En passthrough, le GPU physique appartient à une VM
Le passthrough PCIe donne à une machine virtuelle le contrôle d’un périphérique physique. La VM IA utilise le GPU avec son propre pilote invité. Pendant cette affectation, l’hôte et les autres VM ne peuvent pas utiliser simultanément la même carte pour leurs calculs.
Dans la VM IA, un service de modèles partagé peut traiter plusieurs requêtes. Cela diffère du partage de la carte entre plusieurs VM. L’adéquation d’une solution vGPU distincte dépend aussi du GPU, de l’hyperviseur, des pilotes, des configurations prises en charge et des licences.
Une VM offre un environnement système clairement attribué : système d’exploitation, serveur de modèles et données nécessaires peuvent être gérés ensemble. Le GPU reste un périphérique physique avec ses propres prérequis.
Vérifier toute la chaîne matérielle avant l’installation
La documentation Proxmox exige la prise en charge IOMMU, y compris le remappage des interruptions. Processeur, carte mère, micrologiciel et prise en charge Linux doivent être compatibles. La seule mention VT-d ou AMD-Vi ne remplace pas cette vérification.
Le groupe IOMMU de l’emplacement choisi compte également. Le GPU et ses fonctions associées doivent être séparés de manière appropriée des autres périphériques nécessaires. La documentation Linux VFIO explique pourquoi le groupe constitue la limite d’affectation et d’isolation. Un autre emplacement peut produire un regroupement différent.
Il faut aussi vérifier l’espace, la connexion électrique PCIe, l’alimentation et le refroidissement. Dans l’invité, un pilote GPU adapté et la prise en charge par le service de modèles sont nécessaires. Pour le passthrough GPU, Proxmox recommande généralement q35 avec OVMF/UEFI et PCIe ; le micrologiciel de la carte doit également convenir. Les réglages précis dépendent du matériel utilisé.

La capacité disponible est un budget commun
L’exemple de planification part d’un hôte de virtualisation existant, avec des applications métier et une VM IA supplémentaire. Temps processeur, mémoire, stockage et réseau restent partagés. Une importation de documents non limitée ou le démarrage d’un modèle ne doivent pas ralentir inopinément les autres applications.
La VM reçoit donc une configuration explicite et des limites de charge. Mémoire graphique, longueur du contexte et requêtes simultanées sont testées ensemble. Affecter davantage de RAM à la VM n’augmente pas la VRAM physique de la carte. Le déport vers le processeur peut modifier le comportement et nécessite une mesure distincte.
Pour comparer équitablement, consigner la version du modèle, les entrées, le contexte et le parallélisme. Évaluer qualité, première réponse, sortie suivante, attente et effets sur les autres VM. Un pourcentage global de surcoût de virtualisation serait peu utile sans ce test concret.
VM ou machine dédiée : que change l’exploitation ?
| Question | VM IA avec passthrough GPU | Serveur IA dédié |
|---|---|---|
| Ressources | GPU affecté de manière fixe ; coordonner les autres ressources de l’hôte avec les VM existantes. | Les ressources de calcul et de mémoire sont disponibles pour le système dédié. |
| Maintenance | Planifier ensemble pilotes invités, exploitation des modèles et mises à jour Proxmox/hôte. | Système d’exploitation et modèles dans un périmètre de maintenance distinct. |
| Changement d’hôte | Les périphériques PCI affectés directement empêchent la migration à chaud habituelle. Pour migrer une VM arrêtée, vérifier le matériel cible et l’affectation. | Déplacement ou remplacement par une reprise préparée sur un autre matériel. |
| Sauvegarde | Examiner ensemble disques VM, cohérence applicative, configuration et affectation des périphériques. | Organiser séparément les données système/applicatives et la restauration. |
| Effort | L’infrastructure existante peut servir ; compter l’intégration et les dépendances supplémentaires à l’hôte. | Prévoir matériel et ressources du site dédiés, avec une maintenance mieux séparée. |
Un cluster existant ne rend pas automatiquement déplaçable sans interruption une VM IA liée au matériel physique. Un redémarrage sur un autre nœud exige des ressources GPU compatibles, une affectation valide et une procédure réellement testée. Les exigences du service déterminent si cette préparation suffit ou si un autre nœud de service est pertinent.
Une restauration doit démontrer plus qu’une VM qui démarre
Une copie du disque virtuel ne contient pas l’état courant de la carte graphique physique. La restauration doit donc aussi vérifier versions des modèles, configuration, droits sur les données et nouvelle affectation du périphérique. Un instantané sur le même hôte ne remplace pas une sauvegarde séparée.
La recette comprend un redémarrage normal de la VM, un redémarrage de l’hôte, un changement de pilote/noyau dans la fenêtre de maintenance prévue et une restauration planifiée. Ensuite, tester une vraie requête au modèle et les autres applications. Cela montre si le périphérique redevient correctement disponible après un redémarrage.
Un GPU utilisé uniquement comme accélérateur de calcul n’a pas besoin d’écran connecté. La console Proxmox n’affiche pas simplement l’image d’un GPU en passthrough. Le service IA s’utilise via son interface ou son API prévue.
Étayer la décision avec un pilote limité
DAXS précise d’abord la tâche, l’hôte existant, le périmètre d’utilisation et l’interruption acceptable. Un pilote limité teste ensuite l’affectation du périphérique, la qualité fonctionnelle et les effets sur l’exploitation. Selon les résultats, une VM, une machine dédiée ou un service externe peuvent convenir.
La présentation Proxmox pour les entreprises explique le choix général de plateforme. La page sur l’infrastructure LLM locale et le pilote de test de charge approfondissent le dimensionnement. Pour le service partagé, l’article sur Ollama et Open WebUI complète l’architecture.
Discuter du modèle d’exploitation IA et de l’infrastructure existante.
Sources : Proxmox : passthrough PCIe (lien externe) · Proxmox : migration des machines virtuelles (lien externe) · Linux : VFIO et groupes IOMMU (lien externe) · NVIDIA : matrice de prise en charge vGPU (lien externe) · Ollama : prise en charge matérielle (lien externe).