Une recherche par IA répond à une question interne avec une citation pertinente. C’est impressionnant techniquement, mais la personne qui a posé la question avait-elle le droit de lire le document cité ? C’est là que se joue l’aptitude d’une solution RAG à un usage en entreprise.
Le RAG associe recherche et modèle de langage.
La génération augmentée par récupération, ou Retrieval-Augmented Generation, complète une requête par des informations pertinentes issues de sources. Les documents sont préparés et rendus consultables ; des extraits sélectionnés servent ensuite de contexte au modèle de langage. Le modèle peut ainsi produire une réponse accompagnée de références aux sources.
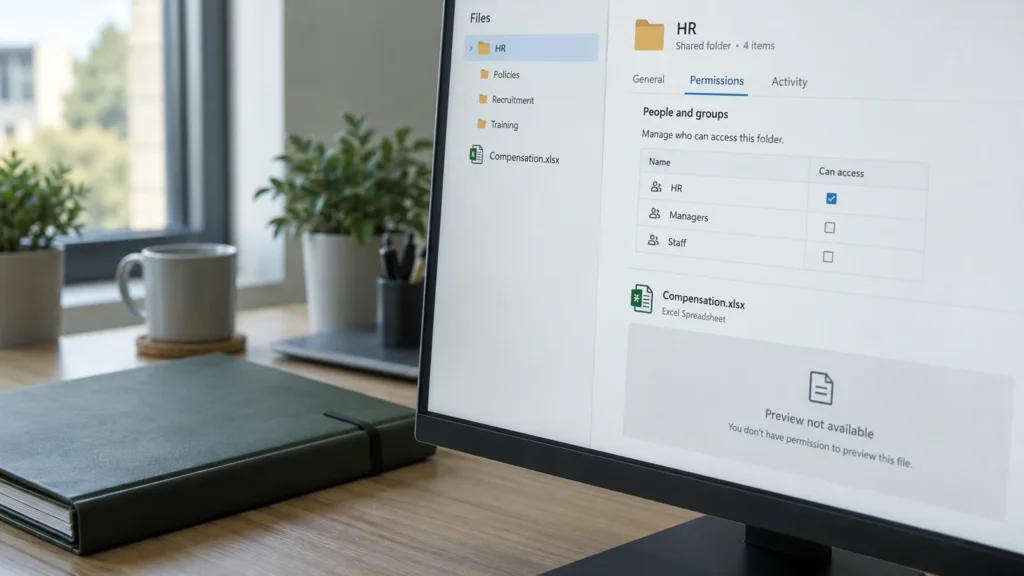
Cette association est utile lorsque les bonnes informations sont à jour et accessibles à l’utilisateur. Elle devient risquée lorsqu’un index partagé restitue tous les documents sans limitation effective des droits. Se connecter à l’interface de chat ne donne pas pour autant accès à chaque document qui peut y être trouvé.
Le contrôle d’accès doit intervenir avant le modèle.

L’application détermine l’identité de l’utilisateur à partir d’un mécanisme d’authentification fiable. La recherche limite les résultats et les extraits au périmètre autorisé. Seul ce contexte autorisé est transmis au modèle de langage. L’index lui-même, ses accès d’administration et sa connexion aux sources nécessitent également des contrôles adaptés.
Une consigne demandant au modèle de ne pas divulguer d’informations confidentielles intervient trop tard si elle constitue la seule protection d’accès. Les données interdites auraient déjà été traitées. Masquer une citation après coup ne corrige pas non plus ce transfert de données.
Les chemins secondaires comptent aussi.
- Titres des résultats
- Un titre évoquant une mesure envisagée concernant le personnel peut déjà être confidentiel. Le filtrage des droits doit couvrir davantage que le seul texte intégral du document.
- Caches
- Une réponse produite pour l’utilisateur A ne doit pas être réutilisée pour B sans vérification. L’identité, le tenant et les droits applicables doivent être pris en compte dans la conception du cache.
- Liens vers les sources
- Une référence cliquable doit permettre un accès à l’original toujours soumis aux autorisations. Un lien de téléchargement privé ne doit pas créer un accès général.
- Journaux
- Les recherches, les extraits et les détails d’erreurs peuvent contenir des secrets d’affaires. Leur consultation et leur durée de conservation sont limitées.
Les droits changent plus vite que certains index.
Une personne change de service, un projet prend fin ou un partage est révoqué. Les sources et les droits de recherche doivent à nouveau correspondre. L’architecture doit donc prévoir un processus de mise à jour documenté et un délai de réaction adapté.
La révocation des droits constitue un test particulièrement important : après la modification, la même question, initialement autorisée, est reposée avec le même compte. On vérifie aussi si d’anciens caches, aperçus ou réponses enregistrées permettent encore l’accès. Le résultat doit être documenté ; la réussite d’un import ne suffit pas à elle seule.
Les fonctions des produits ne sont pas des briques interchangeables.
Certains services de recherche prennent en charge des contrôles natifs par document ; d’autres nécessitent des filtres explicitement imposés et une synchronisation spécifique. La documentation actuelle d’Azure AI Search distingue par exemple les filtres de sécurité d’autres mécanismes intégrés, dont certains sont signalés comme étant en préversion. L’API et la version doivent donc être prises en compte dans le choix d’architecture.
Quel que soit l’outil, la recette doit démontrer les sources qu’une identité de test peut consulter et celles qui ne lui sont pas fournies. Les limites souhaitées ne se déduisent pas après coup d’une réponse aléatoire du modèle.
Un pilote vérifiable associe utilité et protection.
DAXS peut commencer avec un ensemble délimité de connaissances : responsables de sources identifiés, documents à jour, comptes de test, critères de réponse clairs et tests négatifs traçables. Le périmètre n’est élargi qu’une fois la recherche, les droits et les références aux sources validés.
La page spécialisée Connaissances d’entreprise et RAG présente l’import et les requêtes dans leur ensemble. Sécurité de l’IA approfondit le partage excessif, les identités et les droits des agents.
Sources : Microsoft : contrôle d’accès au niveau du document · OWASP : faiblesses des vecteurs et des embeddings. Le schéma présente une architecture possible, sans données de clients.